CIP y disponibilidad: qué revisar ante CVE-2026-9637
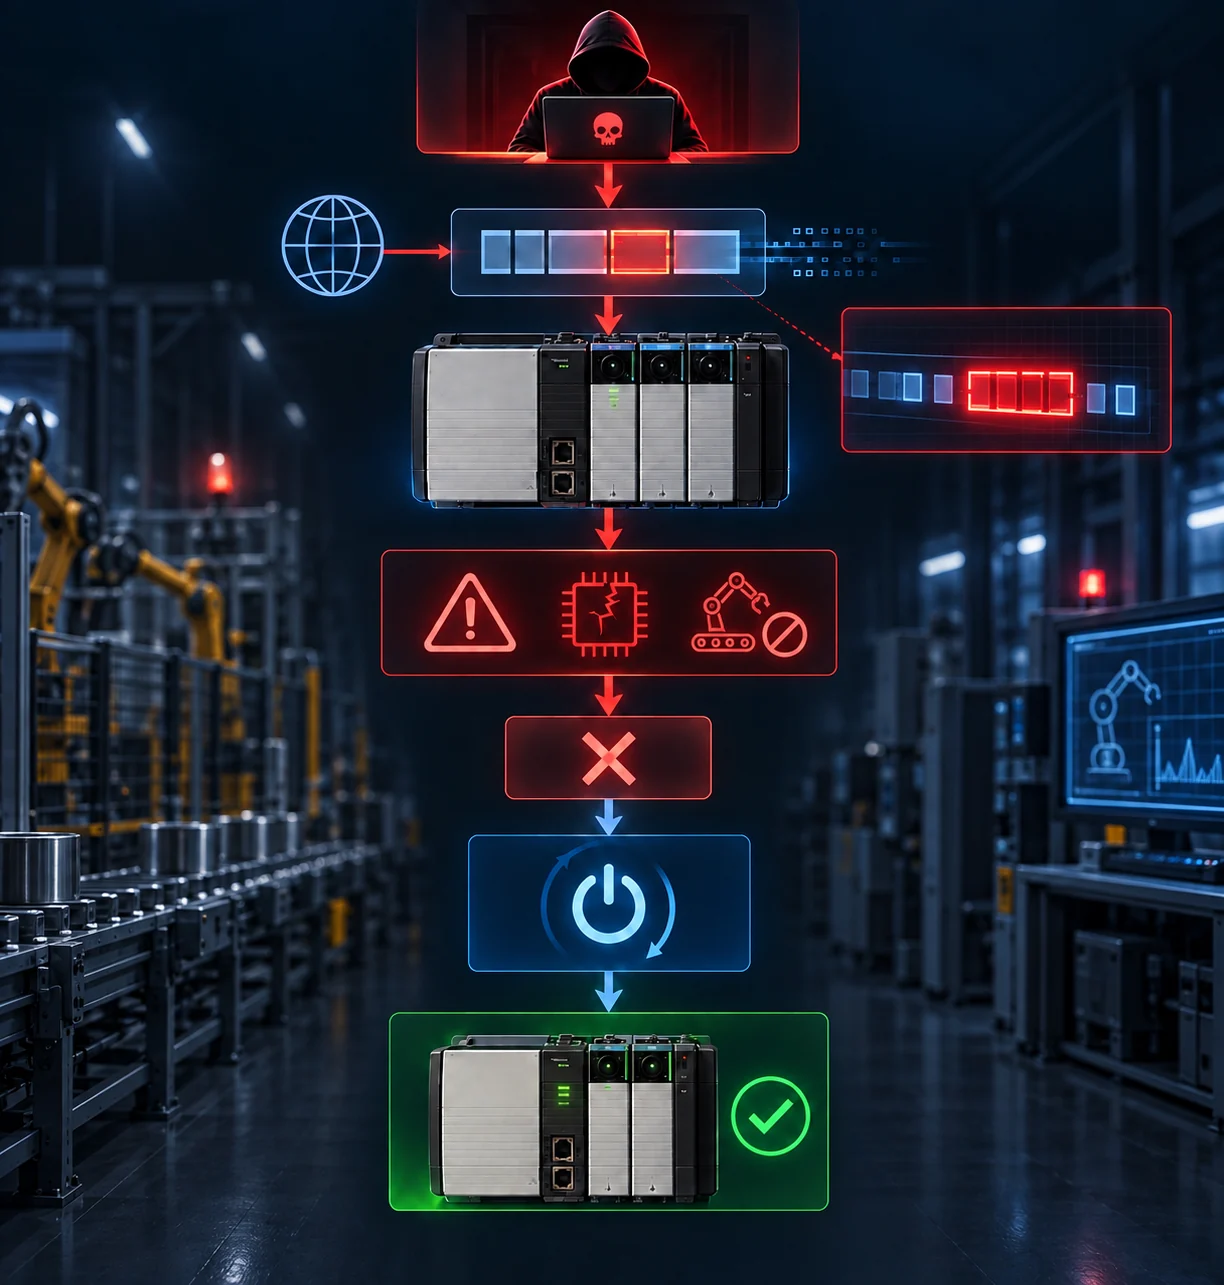
Ilustración conceptual aportada por el autor; no documenta un ataque real ni demuestra exposición a Internet. Ver imagen completa ↗
Lectura del esquema: El símbolo verde representa recuperación del controlador. Un ciclo de alimentación no corrige la vulnerabilidad ni garantiza que sea seguro reanudar el proceso.
Para interrumpir un sistema de control no siempre es necesario modificar el programa de un PLC. Una pérdida de disponibilidad también puede tener consecuencias para la operación.
Qué describe el fabricante
El 1 de septiembre de 2026, Rockwell Automation publicó SD1792 sobre CVE-2026-9637. Describe una validación incorrecta de la longitud de entrada al procesar mensajes CIP, que puede provocar un Major Nonrecoverable Fault (MNRF). El boletín indica que se necesita un ciclo de alimentación para recuperar el controlador.
La tabla del fabricante incluye ControlLogix 5580, CompactLogix 5380, GuardLogix 5580 y Compact GuardLogix 5380, con estos rangos de firmware:
- Afectados: V33 y anteriores; V34.011–V34.014; V35.011–V35.013; V36.011–V36.012.
- Versiones corregidas indicadas: V34.015, V35.014, V36.013 y V37.011.
Debe comprobarse la combinación exacta de catálogo y firmware en el aviso y en la documentación del producto antes de planear una actualización. No se debe extender la afectación a toda la familia Logix por compartir el nombre comercial.
Disponibilidad del PLC y continuidad del proceso
El efecto descrito por esta CVE es una denegación de servicio; la fuente no la presenta como una vía para modificar la lógica. Mi lectura operacional es que perder un controlador puede afectar mucho más que una pantalla de diagnóstico, dependiendo de su función dentro de la máquina o instalación.
Por ejemplo, una interrupción podría detener una secuencia, impedir nuevas órdenes o exigir una intervención del operador. El resultado real depende del diseño del proceso, de las dependencias, de la redundancia y del comportamiento previsto ante fallas. No corresponde afirmar que todos los entornos tendrán el mismo impacto.
Además, un controlador recuperado no equivale automáticamente a una operación normalizada. Antes de reanudar el proceso hay que verificar condiciones de arranque, estados de campo, permisos operativos y coordinación con quienes tienen responsabilidad sobre la instalación.
Recuperar también implica investigar
La pregunta después del evento es: ¿qué comunicación precedió al fallo y desde dónde llegó? Si solo se restablece la alimentación y se pierde el contexto, puede resultar difícil distinguir un problema recurrente de una intervención no autorizada.
Como recomendación de arquitectura, conviene relacionar alarmas del controlador, registros de estaciones y evidencia de red dentro de una misma línea de tiempo. La disponibilidad de esos datos depende de la instrumentación instalada; un inventario de direcciones IP, por sí solo, no permite atribuir una acción a una persona.
Qué revisaría antes y después
- Identificar: confirmar modelos, firmware y función de cada controlador afectado.
- Planear: evaluar la versión corregida compatible, realizar pruebas y programar la intervención con Operaciones.
- Limitar: documentar qué equipos necesitan comunicaciones CIP y revisar accesos innecesarios.
- Observar: conservar registros útiles y detectar desviaciones respecto de las comunicaciones esperadas, evitando pruebas intrusivas sobre producción.
- Recuperar: seguir el procedimiento del fabricante y validar el estado del proceso antes de reanudar la operación.
Estas medidas de arquitectura complementan la corrección del firmware. Reducir exposición o mejorar la detección no elimina la falla de software.
¿Sabes qué dispositivos pueden enviar tráfico CIP hacia tus PLC y qué información conservarías para explicar una interrupción inesperada?